Evropa nemá žádnou OpenAI, Anthropic, Google, Muska, Zuckerberga, a dokonce ani DeepSeek, Alibabu, ByteDance, Moonshot nebo Baidu, kteří by pro ni tvořili velké jazykové modely špičkové světové kvality. Přesto hned dva evropské LLM za poslední týden způsobily docela slušné vlny. Znamená to, že se evropská AI konečně probrala z letargie a zapojila se do „AI zbrojení“, nebo jde ve skutečnosti o trochu něco jiného?
Kromě toho, že jsou oba modely z Evropy, mají společné už jen to, že slibují otevřené váhy ke stažení a že jsou plně v souladu s evropským právem, především s nařízením EU o umělé inteligenci (takzvaným AI Actem), který vstoupil v platnost před dvěma lety. Pak už toho vlastně moc společného nemají.
První z modelů byl představený 3. října. Jde o model Kolibri 1 německého AI startupu Aleph Alpha a s trochu výkonnějším hardwarem jej zvládnete provozovat lokálně, k ničemu vám to ale nejspíš nebude. Krom toho, že model nezvládá češtinu, což u nás docela limituje jeho profesionální použití, byl speciálně vytvořený pro kriticky důležité aplikace ve státní a veřejné správě a průmyslu.
Trénován byl jako bilingvní s tím, že jeho nativním jazykem je němčina (s důrazem na administrativní, právní a podnikové použití) a poradí si také s angličtinou. Také aby ne, když 62,5 procenta tréninkových dat se nacházelo právě v anglickém jazyce. Ocenit jej mají všude tam, kde při práci s AI vyžadují důslednou kontrolu nad daty a doložitelný soulad s evropskými předpisy.
Kdyby byly o smyslu poměrně limitovaného a ne příliš výkonného modelu nějaké pochybnosti, tak Ilhan Scheer, generální ředitel Aleph Alpha, nenechává nikoho na pochybách: „Suverenita v oblasti AI pro nás znamená svobodu volby díky zachování schopnosti tuto technologii vytvářet a dále rozvíjet, a také poskytnutí kontroly zákazníkům nad tím, jak ji využívají. Naší ambicí je zavést tyto možnosti do každodenního provozu v průmyslu i veřejné správě.“
Kdyby ale Kolibri představoval jedinou aktuální odpověď na současný stav světových AI závodů, pravděpodobně by vůbec nestál za řeč. Zajímavé je to v kontextu. Jen tři dny po něm totiž francouzský Mistral, o kterém v poslední době bylo slyšet hlavně v kontextu v létě oznámeného partnerství s Microsoftem, uvolnil funkční veřejný náhled svého modelu Mistral Large 4 s oficiální přezdívkou Le Chonk (tlouštík).
Le Chonk je již použitelný mnohem univerzálněji a také umí česky. Mimo jiné, poměrně dobře se s ním totiž dorozumíte ve více než 160 jazycích.
Co jsou u velkého jazykového modelu váhy (weights)
Váhy u velkého jazykového modelu říkáme milionům až miliardám číselných parametrů, které tvoří paměť a znalosti neuronové sítě modelu. V neuronové síti nám váhy říkají, jak moc ovlivňuje jeden neuron (či token) druhý. Přímo také ovlivňují velikost modelu. Když se řekne, že má model bilion parametrů, znamená to, že obsahuje bilion číselných vah, a jejich velikost v součtu také určuje, kolik místa v operační paměti model zabere.
Váhy také můžeme rozdělit na uzavřené a otevřené. U špičkových modelů od Anthropicu a Open AI jsou například váhy vždy tajné, jde o součást firemního know-how a v ideálním světě by neměly opustit firemní servery. Vedle toho existují modely s open-source váhami. V takovém případě si může kdokoli soubor vah stáhnout a spustit si následně model umělé inteligence na dostatečně výkonném vlastním hardwaru. Klasickým příkladem jsou čínské modely, modely evropského Mistralu nebo LLaMA od Mety.
Mistral Large 4 je již mnohem zajímavější. Začít můžeme třeba právě tou jazykovou vybaveností. Krom toho, že perfektně ovládá všechny úřední jazyky EU, podporuje již zmiňovaných více než 160 dalších. Pro srovnání GPT-4o od OpenAI oficiálně velmi dobře podporuje lehce přes padesát jazyků a pro současnou rodinu modelů GPT-6 (modely Astra, Sol a Luna) se odhaduje až 95 jazyků.
Disponuje jedním bilionem parametrů, přičemž 49 miliard z nich je aktivních (technologie využívající „směsici expertů“, která pomáhá udržet provozní náklady v rozumné míře) a stejně jako americké modely bez potíží zvládá na vstupu i obrazový vklad. Na špičkové americké modely je to pořád docela málo, ale je to rozhodně pokrok.
Pro kontext, u GPT-6 se odhaduje, že disponuje až deseti biliony parametrů. Těm čínským se již ale model Mistralu blíží. Špičkové čínské LLM dnes totiž dosahují velikosti od 1 (Qwen3-Max od společnosti Alibaba) do 2,8 (Kimi K3 od čínského startupu Moonshot AI) bilionu parametrů.
Krom toho je to největší evropský model s otevřenými váhami, který je multimodální, disponuje schopností uvažování a využívá architekturu Mixture of Experts (směsi expertů), díky níž není při každém dotazu aktivní celý model, ale jen malá část jeho neuronové sítě, což pomáhá držet pod kontrolou náklady na provoz. Právě zde najde uplatnění oněch 49 miliard aktivních parametrů.
To ale samo o sobě není na modelu Le Chonk to nejzajímavější. Mnohem podstatnější zprávou podle mého názoru je, že byl celý model natrénovaný kompletně od nuly, a to výhradně v Evropě. Ještě lepší zprávou by bylo, kdyby toho bylo možné dosáhnout na evropském hardwaru, ale to samozřejmě je a minimálně ještě dlouho bude až příliš velká utopie.
Takhle musela francouzská AI laboratoř vzít zavděk 3800 kartami Nvidia Grace Blackwell, které má rozmístěné v několika svých evropských datacentrech. Ty provozuje bez externího zahraničního partnera a plně v souladu s evropským právem. To je docela důležité, protože na stejné infrastruktuře běží i samotný model.
I když nám Mistral zatím neuvedl žádné bližší detaily o přesných hardwarových požadavcích, je model zároveň dostatečně malý na to, aby se jej dalo rozběhat i lokálně. Tedy ne přímo na běžném domácím hardwaru, ale AI server s méně než deset GPU HGX B300 od Nvidie by měl chod modelu bez zadýchání zvládnout.
Model se momentálně nachází ve fázi předběžného přístupu, což znamená, že si jej můžete vyzkoušet přes rozhraní Mistralu, na samotné zveřejnění vah si budeme muset ještě počkat.
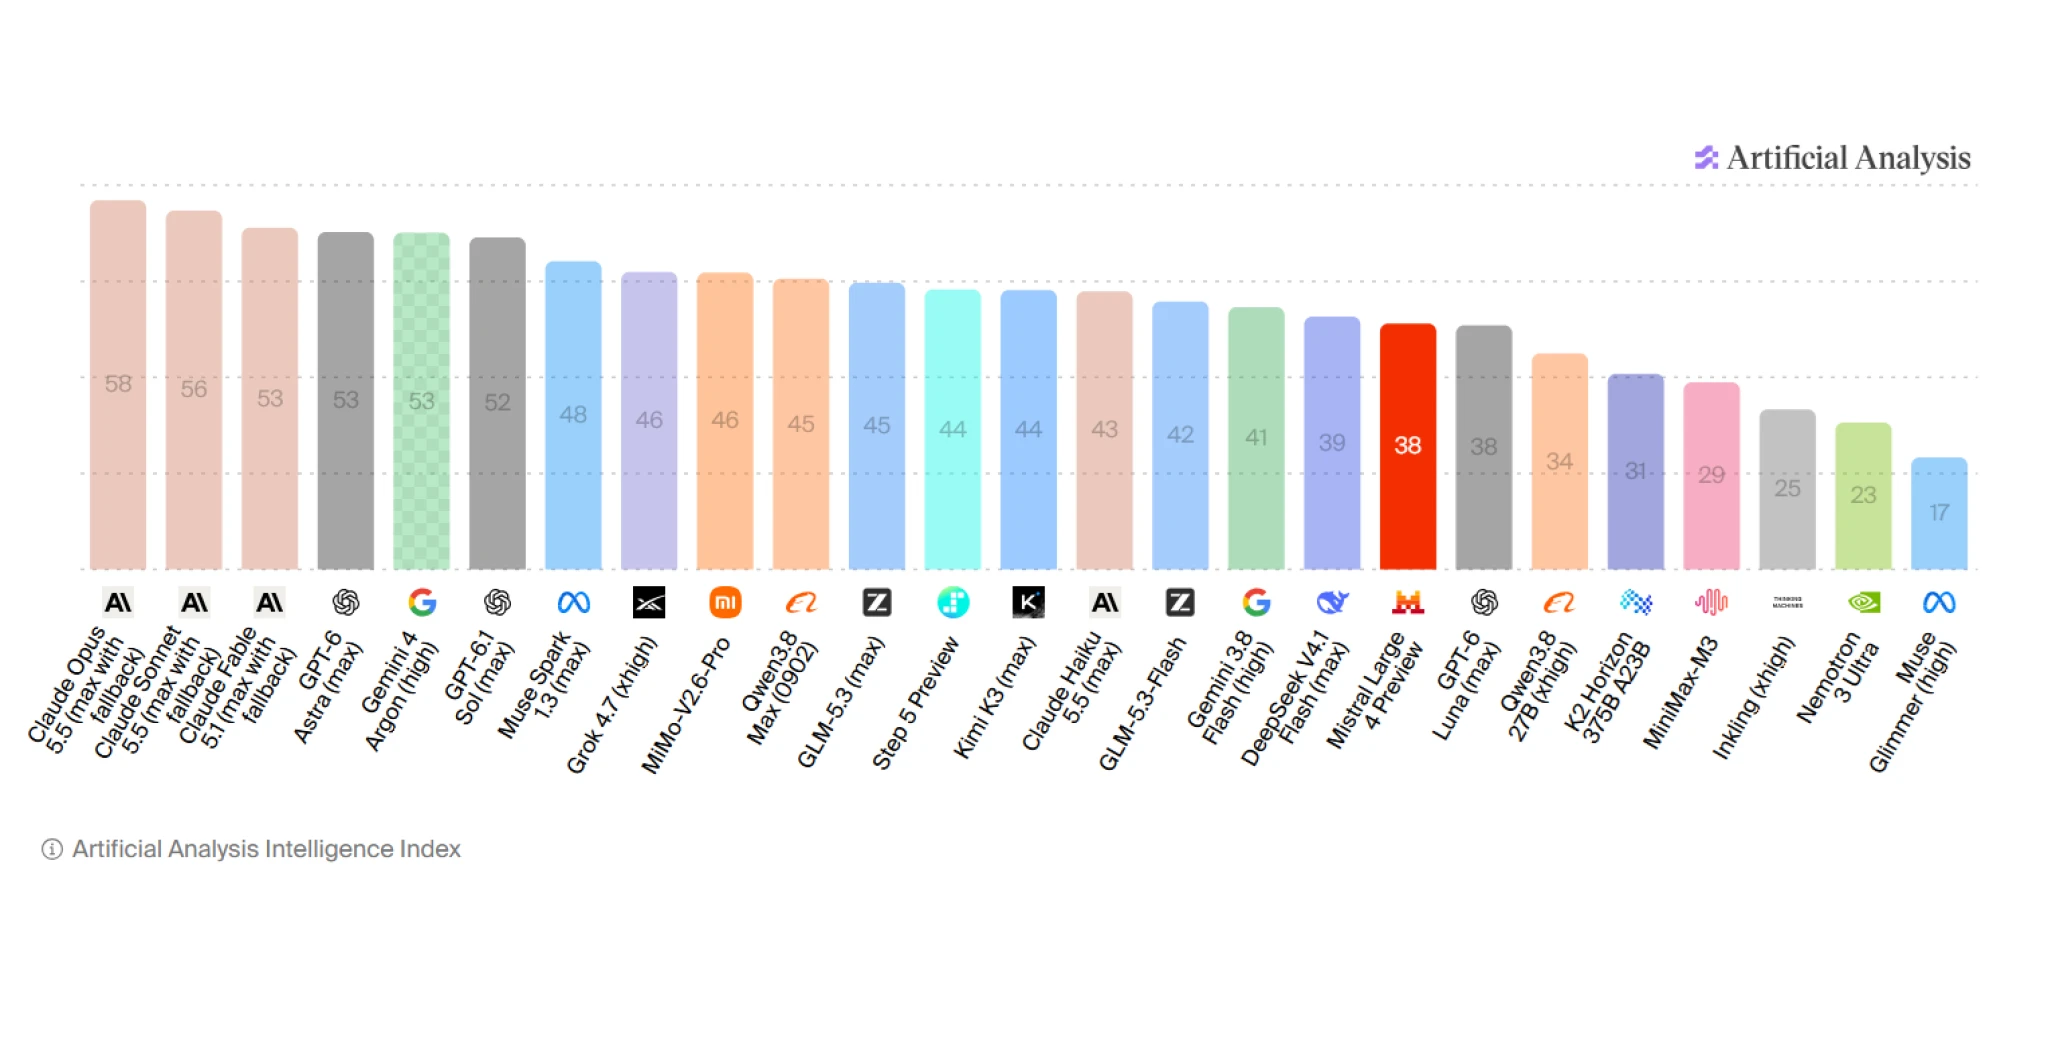
Jak si model stojí výkonově ve srovnání s nejlepší světovou konkurencí? Podle prvních testů analytické společnosti Artificial Analysis Le Chonk celkem nepřekvapivě silně zaostává oproti předním modelům OpenAI s Anthropicu, ale i oproti špičkovým čínským modelům.
Podle souhrnného indexu Artificial Analysis Intelligence si nicméně alespoň vede o něco lépe než GPT6 Luna (max) právě od OpenAI. Nalezneme jej zde těsně za modelem DeepSeek V4.1 Flash (max). Velkou slabinou modelu je hlavně cena za token. Model nicméně docela slušně překonává nejvýkonnější americký model s otevřenými vahami (Inkling od AI laboratoře Thinking Machines Lab).
To v praxi znamená, že v okamžiku, kdy budou uvolněny jeho váhy, bude představovat přinejmenším špičkovou alternativu všude tam, kde nechcete důvěřovat v Číně natrénovaným modelům.
 Artificial Analysis
Sám Mistral pak vyzdvihuje ještě jeden aspekt, který je alespoň pro Evropany jednou z velkých bolístek amerických modelů. Le Chonk má totiž podle interních testů Mistralu patřit k nejvýkonnějším modelům, pokud jde o testy kybernetické bezpečnosti.
Dané je to nejspíš hlavně umělými omezeními, které americké laboratoře OpenAI i Anthropic implementují do svých modelů přístupných široké veřejnosti z obav o potenciální zneužití útočníky. Modely pak mají tendenci odmítat většinu dotazů a úkolů, které jen trochu zavánějí kyberbezpečností nebo penetračním testováním.
Když to tedy shrneme, ani Kolibri, ani Le Chonk zatím nepředstavují nic, z čeho by si svět měl ihned sednout na zadek, poprvé lze ale s poměrně vysokou pravděpodobností říci, že jde rozhodně o evropský krok správným směrem.
A i když to tak na první pohled dnes nemusí vypadat, AI závody se do budoucna mohou ukázat mnohem více jako maraton než sprint a v takovém případě bude mnohem důležitější vytrvalost než největší výbušná síla na začátku.
Ostatně sám Mistral tvrdí, že jde jen o první z řady nových modelů, jejichž vývoj umožnilo nedávné investiční kolo série D, tak se nechme překvapit, s čím přijde dále. Lze také předpokládat, že se, podobně jako je to dnes běžné u předních amerických modelů, bude výkon modelu skrze další reinforcement learning výrazně zlepšovat.